自适应多目标状态预测
Adaptive Visual Interaction Based Multi-Target Future State Prediction For Autonomous Driving Vehicles
融合外观与运动信息,以自适应视觉交互网络预测驾驶视频中多个目标的下一帧状态。
文章目录 · 5 节
从前六帧预测第七帧
驾驶视频里,相机和车辆同时移动,目标还会进入或离开画面。这篇工作尝试结合目标外观、帧间运动和目标之间的关系,预测下一帧状态。主要实验使用连续六帧作为输入,预测第七帧。
外观、运动与交互
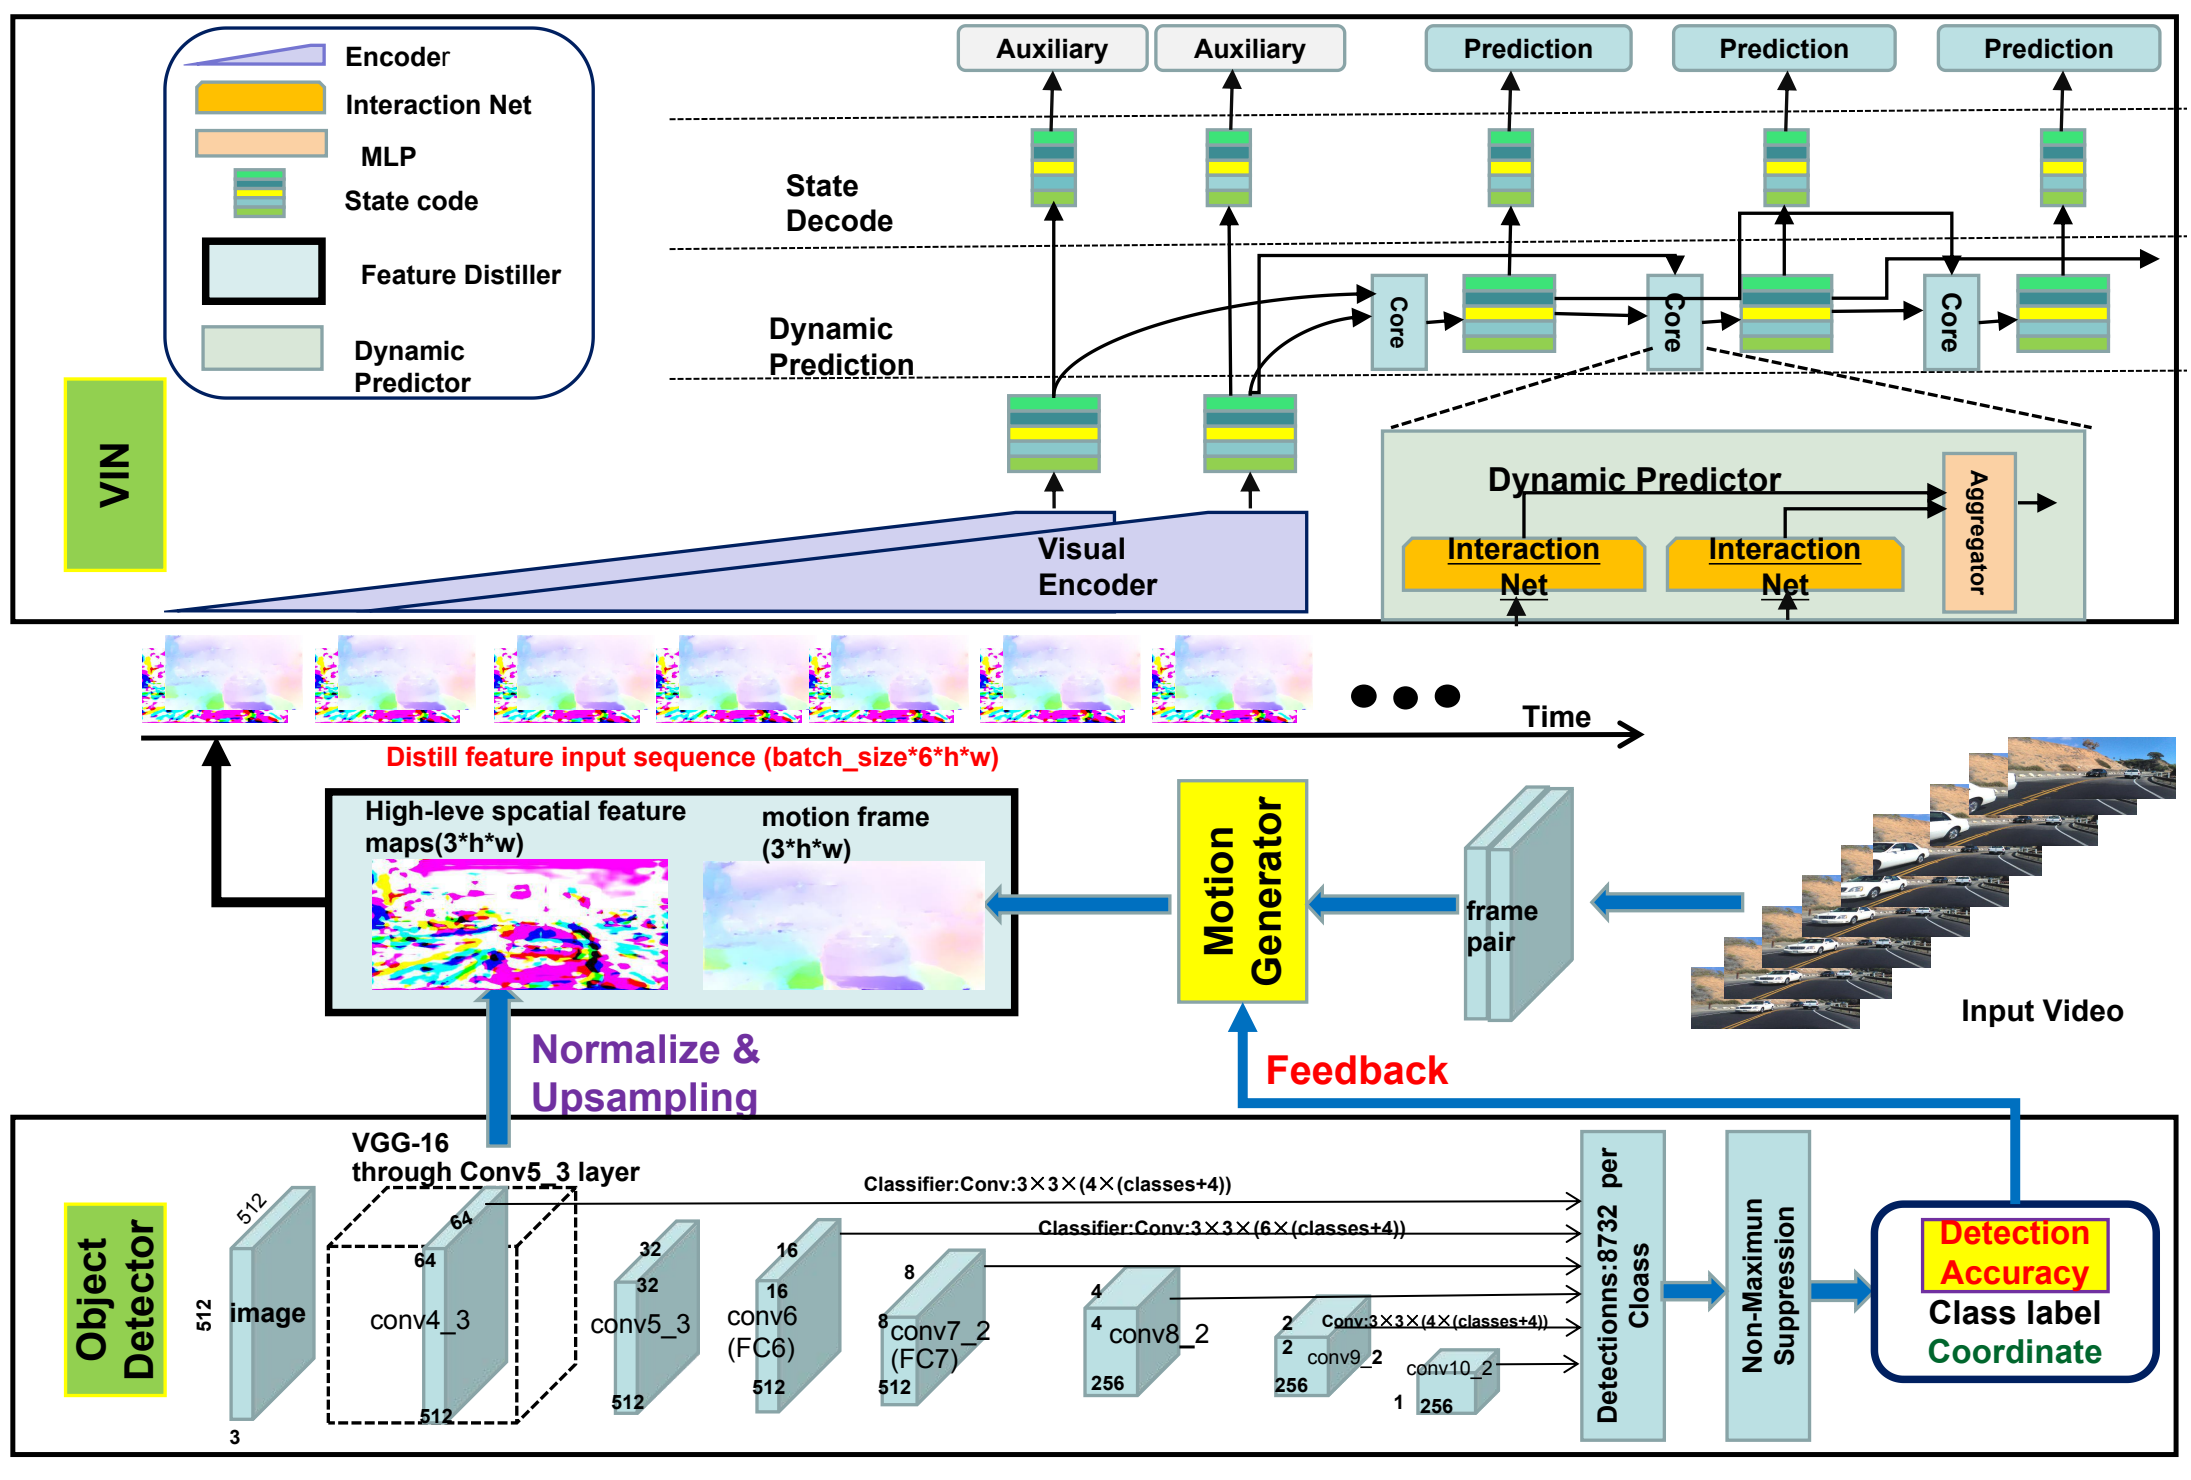
模型由三个部分组成:SSD 检测目标并提供外观信息,TVNet 提取帧间运动,视觉交互网络 VIN 汇合这些信息进行预测。检测得分还参与调整运动生成过程,三个模块分阶段训练。
为适应目标数量变化,视频被切成目标数稳定的短区间,再为每个区间配置交互表示。实现中的区间目标数为 0–6。
运动信息和目标关系带来了什么
论文在 Udacity CrowdAI 和 Autti 数据上评估。作者稿表 III 中,双流加 Interaction Network 的 mAP 为 79.45;仅用空间信息、保持同一预测器时为 76.53;双流加 LSTM 为 65.59。差值分别是 2.92 和 13.86 个百分点。
下图展示状态预测与标注的对比,a–c 为短期预测,d 为长期预测示例。运动量由图像光流和检测框推导,并不是经过物理标定的车辆速度。
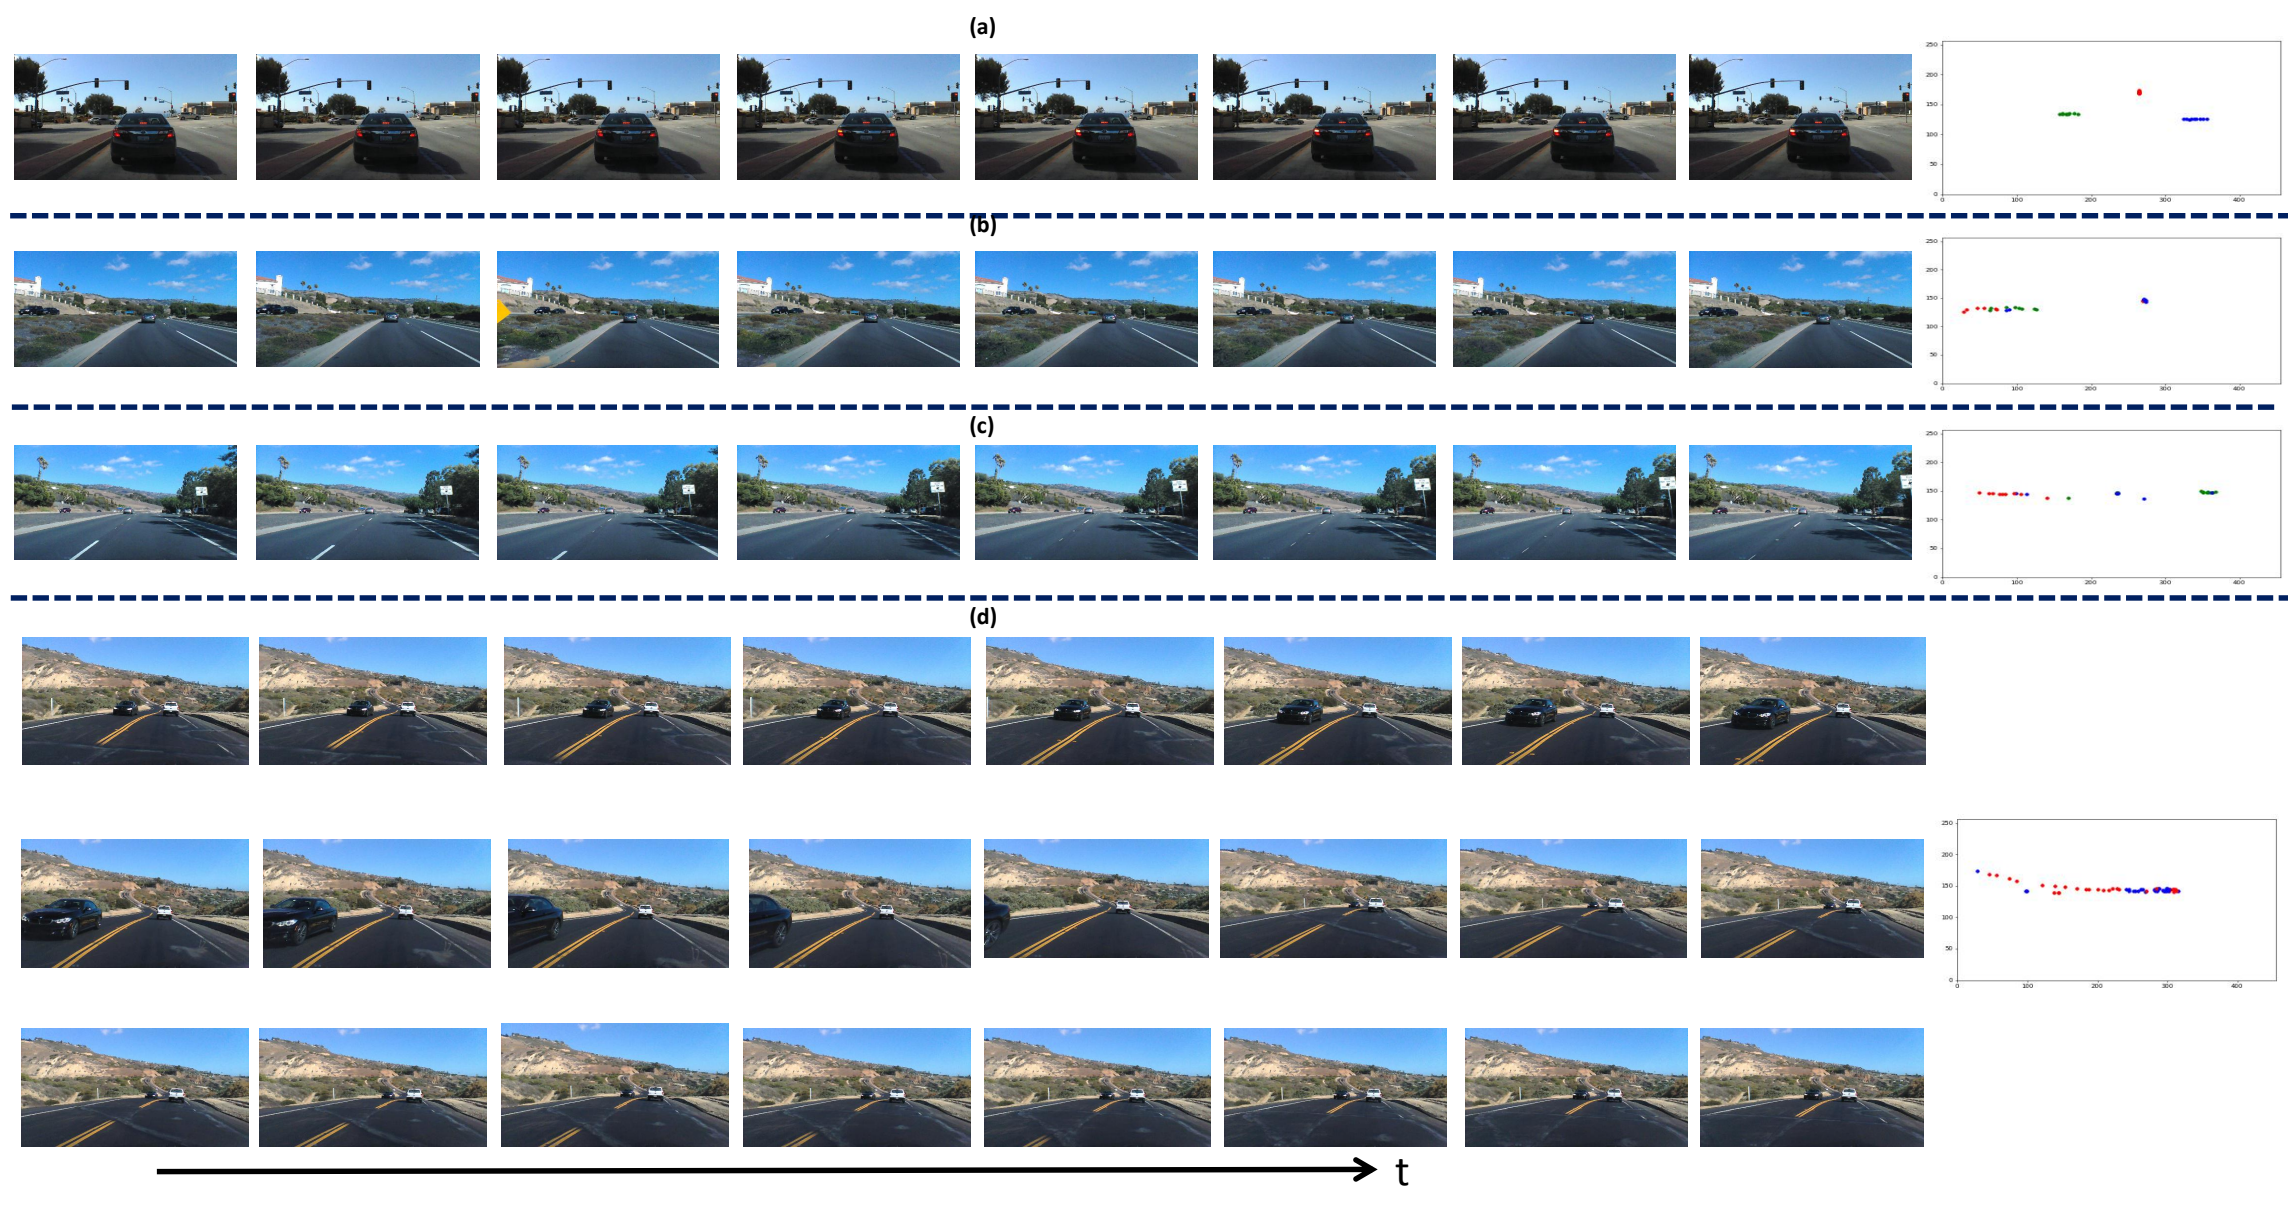
检测错误、运动估计误差会继续影响预测。缺少动态目标、相邻帧变化过小等情况也可能失败。因此,这里的评测对象是视频中的目标状态预测,尚未涉及真实车辆的规划与控制验证。
发表信息
我是第二作者,署名 Zixuan Wang。论文发表于 IEEE Transactions on Vehicular Technology,68(5),4249–4261,2019。本页采用正式发表年份 2019。
配图取自 Brunel 大学机构库的公开作者稿,其页码与出版社排版版不同。
English overview
This model combines SSD appearance features, TVNet motion cues, and a visual interaction network to predict future object states in driving videos. It handles changes in the number of objects through short intervals with a stable object count. I am the second author; the journal publication year is 2019.